Qué probaría antes de escalar esta idea.
- PREGUNTA DE PRUEBA
- ¿Una interfaz estructurada mejora la repetibilidad sin reducir la capacidad del agente para explicar y recuperar sus fallos?
- ENTRADA
- 30 tareas de repositorio, BashOnly frente a Atomic y Python, el mismo modelo y diez semillas por tarea.
- MÉTRICA
- Pass@1, pass^5, pasos, tokens, precisión de archivos explorados y tasa de recuperación tras un error.
- PARADA
- Parar si Atomic no mejora al menos 10% relativo en pass^5 o aumenta más de 20% los tokens sin mejorar la resolución.
La arquitectura óptima depende del entorno, de las herramientas disponibles y de cómo se define una tarea completada. No hay una interfaz universal.
Esta prueba es una propuesta editorial: no es un resultado reportado por los autores.
Qué se evaluó, contra qué y qué reportan los autores.
Reconstrucción de la fuente primaria. El resultado está atribuido al paper; no es una réplica independiente.
| Dataset | 65 incidencias de SWE-bench Live · 11.700 trayectorias |
|---|---|
| Tarea | Reparar incidencias reales a nivel de repositorio con agentes de programación. |
| Método | Seis arquitecturas de herramientas × tres modelos actores × diez intentos independientes por combinación. |
| Baseline | BashOnly: arquitectura básica con una única herramienta Bash. |
| Resultado reportado | Sobre 11.700 trayectorias, las interfaces low-level estructuradas mejoran la consistencia hasta 4,7×; la búsqueda en lenguaje natural aumenta más de 11% el acceso a archivos relevantes y la interfaz Python mantiene un rendimiento similar con 41,6% menos pasos y 56,3% menos tokens. |
| Localizador primario | Tabla 2 · consistencia ↗ (sitio externo; abre en una pestaña nueva) |
Resultado, síntesis y traslado no significan lo mismo.
La fuente primaria sostiene el resultado; la lectura y la aplicación pertenecen a esta ficha editorial.
- RESULTADO REPORTADO
Sobre 11.700 trayectorias, las interfaces low-level estructuradas mejoran la consistencia hasta 4,7×; la búsqueda en lenguaje natural aumenta más de 11% el acceso a archivos relevantes y la interfaz Python mantiene un rendimiento similar con 41,6% menos pasos y 56,3% menos tokens.
- SÍNTESIS EDITORIAL
Compara arquitecturas de herramientas para observar cuánto cambia la conducta de un agente cuando cambia la interfaz que le rodea, aunque el modelo de fondo permanezca igual.
- INFERENCIA / TRASLADO
Tratar el harness como una superficie medible: registrar llamadas, errores, decisiones de herramienta y coste por tarea antes de cambiar de modelo.
PREGUNTA FALSABLE¿Una interfaz estructurada mejora la repetibilidad sin reducir la capacidad del agente para explicar y recuperar sus fallos?
Lo esencial antes de invertir más tiempo.
El estudio compara seis arquitecturas de herramientas sobre 11.700 trayectorias. Las interfaces estructuradas mejoran la consistencia hasta 4,7×; algunas configuraciones reducen pasos y tokens sin perder rendimiento.
Sobre 11.700 trayectorias, las interfaces low-level estructuradas mejoran la consistencia hasta 4,7×; la búsqueda en lenguaje natural aumenta más de 11% el acceso a archivos relevantes y la interfaz Python mantiene un rendimiento similar con 41,6% menos pasos y 56,3% menos tokens.
Resultado con localizador exacto · 6 localizadores disponibles.La arquitectura óptima depende del entorno, de las herramientas disponibles y de cómo se define una tarea completada. No hay una interfaz universal.
La unidad real de producto deja de ser modelo más prompt. Es modelo más herramientas más interfaz más memoria más políticas más recuperación. Esa composición se puede diseñar y medir.
El estudio compara seis arquitecturas de herramientas sobre 11.700 trayectorias. Las interfaces estructuradas mejoran la consistencia hasta 4,7×; algunas configuraciones reducen pasos y tokens sin perder rendimiento.
Qué sostiene esta confianza — y qué sigue sin probarse.
Juicio editorial sobre la transferibilidad de esta lectura; no mide calidad académica ni efecto local.
- FUENTE PRIMARIA
- DOCUMENTADO
Lectura primaria completa registrada sobre v1; comprobación: 2026-08-20 · método, resultado y límites revisados; fuente primaria enlazada.
- RÉPLICA LOCAL
- PENDIENTE
No se ha registrado una réplica independiente en este sitio. El código o los datos enlazados, cuando existen, no cuentan como réplica.
- LÍMITES
- DOCUMENTADO
3 límites declarados en la ficha.
- APLICABILIDAD
- ACOTADO
Hay una prueba de transferencia con entrada, métrica y parada; su resultado local todavía no se ha observado.
REGLA EDITORIALLos criterios no se promedian automáticamente. Una fuente leída, un límite claro o un protocolo propuesto no equivalen a una réplica ni a un resultado local.
Qué está reportado y qué conviene comprobar.
Sobre 11.700 trayectorias, las interfaces low-level estructuradas mejoran la consistencia hasta 4,7×; la búsqueda en lenguaje natural aumenta más de 11% el acceso a archivos relevantes y la interfaz Python mantiene un rendimiento similar con 41,6% menos pasos y 56,3% menos tokens.
hasta 4,7× consistencia; >11% acceso; -41,6% pasos; -56,3% tokens · baseline: arquitectura básica con solo Bash · contexto: Seis arquitecturas de herramientas, tres actores y tareas de reparación a nivel de repositorio
Qué estudiaron y qué cambia.
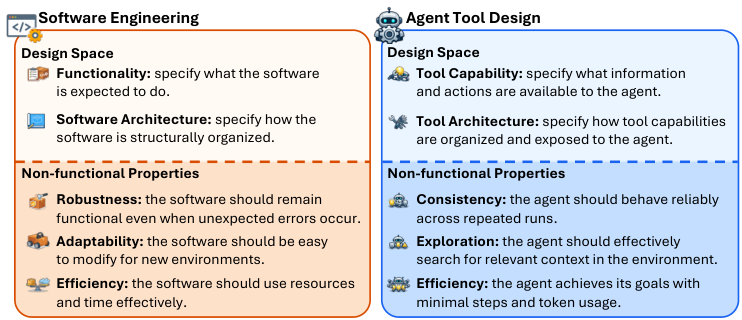
La síntesis está separada de los resultados reportados y de las inferencias.The Devil Is in the Interface parte de una pregunta sencilla pero importante: cuando un agente falla, ¿estamos culpando demasiado al modelo? Los autores separan dos cosas que normalmente aparecen mezcladas. Una es la capacidad de la herramienta —qué información y acciones puede ofrecer— y otra es su arquitectura: cómo se organiza, cómo se presenta y qué pasos obliga a dar al agente. Su tesis es que dos sistemas con capacidades parecidas pueden producir conductas distintas simplemente porque el camino de acceso es diferente.
Para estudiarlo construyen seis configuraciones de herramientas para resolver incidencias reales de repositorios: BashOnly como referencia; Atomic, con operaciones más estructuradas; NLSearch, con búsqueda en lenguaje natural; Python, donde el agente agrupa operaciones en código ejecutable; y dos formas ligeras de andamiaje cognitivo, HypoTrack y Scratchpad. Las prueban sobre 65 instancias de SWE-bench Live, con tres modelos actores —Qwen3Coder-30B, Kimi K2.5 y Claude Sonnet 4.5— y diez intentos independientes por combinación. En total analizan 11.700 trayectorias.
El resultado más interesante es que la arquitectura no cambia demasiado la tasa básica de tareas resueltas cuando las capacidades se mantienen similares, pero sí cambia propiedades que importan mucho en producción. Atomic mejora la consistencia entre intentos repetidos y es la única configuración con una mejora uniforme de pass^k para los tres actores; en Qwen3Coder-30B, por ejemplo, pass^5 pasa de 0,046 con BashOnly a 0,106 con Atomic. NLSearch hace que el agente explore más archivos y encuentre más contexto potencialmente relevante, aunque con menor precisión. Python mantiene un rendimiento parecido con menos pasos y tokens: el resumen del paper reporta un 41,6 % menos de pasos y un 56,3 % menos de tokens.
El paper también matiza la tentación de llamar ‘memoria’ o ‘razonamiento’ a cualquier caja adicional. En las formas ligeras que estudian, Scratchpad y HypoTrack apenas cambian el comportamiento del actor. Eso no demuestra que todo andamiaje sea inútil: demuestra que escribir texto intermedio, por sí solo y sin recuperación, nueva información ni una política de ejecución, puede no ser suficiente para modificar una trayectoria. La mejora aparece cuando la interfaz cambia de verdad la forma de buscar, editar, agrupar acciones o controlar errores.
Mi lectura es que el harness forma parte del producto y debe medirse como tal. No hay una interfaz universalmente ganadora: el efecto depende del actor, la tarea y de si priorizamos consistencia, exploración, coste o resolución. Además, el estudio se concentra en coding agents y en un entorno controlado; no prueba automáticamente que la misma configuración funcione igual en un agente financiero, industrial o doméstico. Lo que sí deja es una regla práctica: antes de cambiar de modelo, instrumentar la superficie que le permite observar, elegir herramientas y recuperarse.
- PROBLEMA
- Solemos atribuir el resultado al modelo y olvidar que la API, la búsqueda, el formato de salida y el orden de las herramientas también forman parte de la inteligencia efectiva.
- MÉTODO
- Compara arquitecturas de herramientas para observar cuánto cambia la conducta de un agente cuando cambia la interfaz que le rodea, aunque el modelo de fondo permanezca igual.
- TIPO DE EVIDENCIA
- Evaluación amplia sobre trayectorias de coding agents; la comparación apunta a consistencia, pasos y coste, no solo a una respuesta final.
- LÍMITE
- La arquitectura óptima depende del entorno, de las herramientas disponibles y de cómo se define una tarea completada. No hay una interfaz universal.
 (sitio externo; abre en una pestaña nueva)
La figura del paper contrapone las propiedades no funcionales de la ingeniería de software con las de un diseño de herramientas para agentes.
Xiangzhe Xu et al. · The Devil Is in the Interface · arXiv:2608.11386v1 · CC BY 4.0
Consultar licencia ↗ (sitio externo; abre en una pestaña nueva)Tratar el harness como una superficie medible: registrar llamadas, errores, decisiones de herramienta y coste por tarea antes de cambiar de modelo.
La lectura también deja rastro.
Guarda una observación junto a la evidencia. Tú escribes aquí; los agentes pueden añadir notas por MCP y aparecerán identificados.
LECTURA AMPLIADAMetodología, implicaciones y preguntas para volver al paper.+
Compara arquitecturas de herramientas para observar cuánto cambia la conducta de un agente cuando cambia la interfaz que le rodea, aunque el modelo de fondo permanezca igual.
La unidad real de producto deja de ser modelo más prompt. Es modelo más herramientas más interfaz más memoria más políticas más recuperación. Esa composición se puede diseñar y medir.
La arquitectura óptima depende del entorno, de las herramientas disponibles y de cómo se define una tarea completada. No hay una interfaz universal.
Cómo lo llevaría a un proyecto
Tratar el harness como una superficie medible: registrar llamadas, errores, decisiones de herramienta y coste por tarea antes de cambiar de modelo.
Preguntas que conviene probar
- ¿Qué parte del rendimiento viene de la herramienta y cuál de la política de selección?
- ¿Qué interfaz reduce errores sin ocultar incertidumbre?
Si tuviera que convertirlo en una prueba mañana.
Mi lectura
El harness no es fontanería: es una superficie de producto con impacto medible.
Esta última frase es una inferencia editorial a partir del paper y de sus posibles implicaciones; no es una afirmación de los autores.
La prueba que queda en pie.
¿Una interfaz estructurada mejora la repetibilidad sin reducir la capacidad del agente para explicar y recuperar sus fallos?