Qué probaría antes de escalar esta idea.
- PREGUNTA DE PRUEBA
- ¿Un registro explícito de entidades, fuentes y políticas reduce el deterioro entre uno y tres saltos de herramienta?
- ENTRADA
- 50 tareas con entidades ambiguas y políticas, comparando ReAct base con un ledger de evidencia en cadenas de 1, 2 y 3 saltos.
- MÉTRICA
- Exactitud de la tarea, exactitud por salto, violaciones de política, llamadas innecesarias y cobertura de evidencia.
- PARADA
- Parar si el ledger no aporta 5 puntos en cadenas de tres saltos o añade más de 15% de llamadas sin recuperar exactitud.
Un benchmark ejecutable no reproduce completamente permisos, latencias, datos incompletos ni consecuencias de una acción real.
Esta prueba es una propuesta editorial: no es un resultado reportado por los autores.
Lo esencial antes de invertir más tiempo.
VAKRA reúne más de 8.000 APIs ejecutables en 62 dominios y evalúa tareas que combinan herramientas, documentos y restricciones en lenguaje natural. El rendimiento cae con fuerza cuando aumenta la profundidad de composición.
VAKRA reporta 70,4% en endpoints de un solo salto y alrededor de 50–51% en APIs composicionales; ciertas consultas no respondibles con políticas caen hasta 2,4%.
Resultado con localizador exacto · 5 localizadores disponibles.Un benchmark ejecutable no reproduce completamente permisos, latencias, datos incompletos ni consecuencias de una acción real.
Ofrece una medida más realista del agente enterprise: no basta con saber llamar un endpoint; hay que saber cuándo, con qué evidencia y bajo qué política hacerlo.
VAKRA reúne más de 8.000 APIs ejecutables en 62 dominios y evalúa tareas que combinan herramientas, documentos y restricciones en lenguaje natural. El rendimiento cae con fuerza cuando aumenta la profundidad de composición.
Qué sostiene esta confianza — y qué sigue sin probarse.
Juicio editorial sobre la transferibilidad de esta lectura; no mide calidad académica ni efecto local.
- FUENTE PRIMARIA
- DOCUMENTADO
Lectura primaria completa registrada sobre v1; comprobación: 2026-08-20 · método, resultado y límites revisados; fuente primaria enlazada.
- RÉPLICA LOCAL
- PENDIENTE
No se ha registrado una réplica independiente en este sitio. El código o los datos enlazados, cuando existen, no cuentan como réplica.
- LÍMITES
- DOCUMENTADO
3 límites declarados en la ficha.
- APLICABILIDAD
- ACOTADO
Hay una prueba de transferencia con entrada, métrica y parada; su resultado local todavía no se ha observado.
REGLA EDITORIALLos criterios no se promedian automáticamente. Una fuente leída, un límite claro o un protocolo propuesto no equivalen a una réplica ni a un resultado local.
Qué está reportado y qué conviene comprobar.
VAKRA reporta 70,4% en endpoints de un solo salto y alrededor de 50–51% en APIs composicionales; ciertas consultas no respondibles con políticas caen hasta 2,4%.
70,4%; 50–51%; hasta 2,4% · baseline: endpoint de un solo salto vs composición multi-hop · contexto: Más de 8.000 APIs ejecutables en 62 dominios y tareas con políticas de uso de herramientas
Qué estudiaron y qué cambia.
La síntesis está separada de los resultados reportados y de las inferencias.VAKRA intenta medir la dificultad que aparece cuando un agente empresarial tiene que cruzar herramientas, documentos y políticas en una misma tarea. Una llamada aislada a una API puede ser correcta y aun así la operación completa fallar por una entidad ambigua, una evidencia mal conectada o una restricción que se pierde en el tercer salto.
El benchmark reúne más de 8.000 APIs ejecutables en 62 dominios y separa tres situaciones: distintos estilos de interacción con APIs, composición multi-hop sobre APIs estructuradas y razonamiento multi-fuente con políticas de uso de herramientas expresadas en lenguaje natural. Para aislar el efecto del modelo, los autores fijan un harness ReAct; verifican la corrección reejecutando las llamadas predichas contra APIs vivas y aceptan varios caminos válidos cuando los hay.
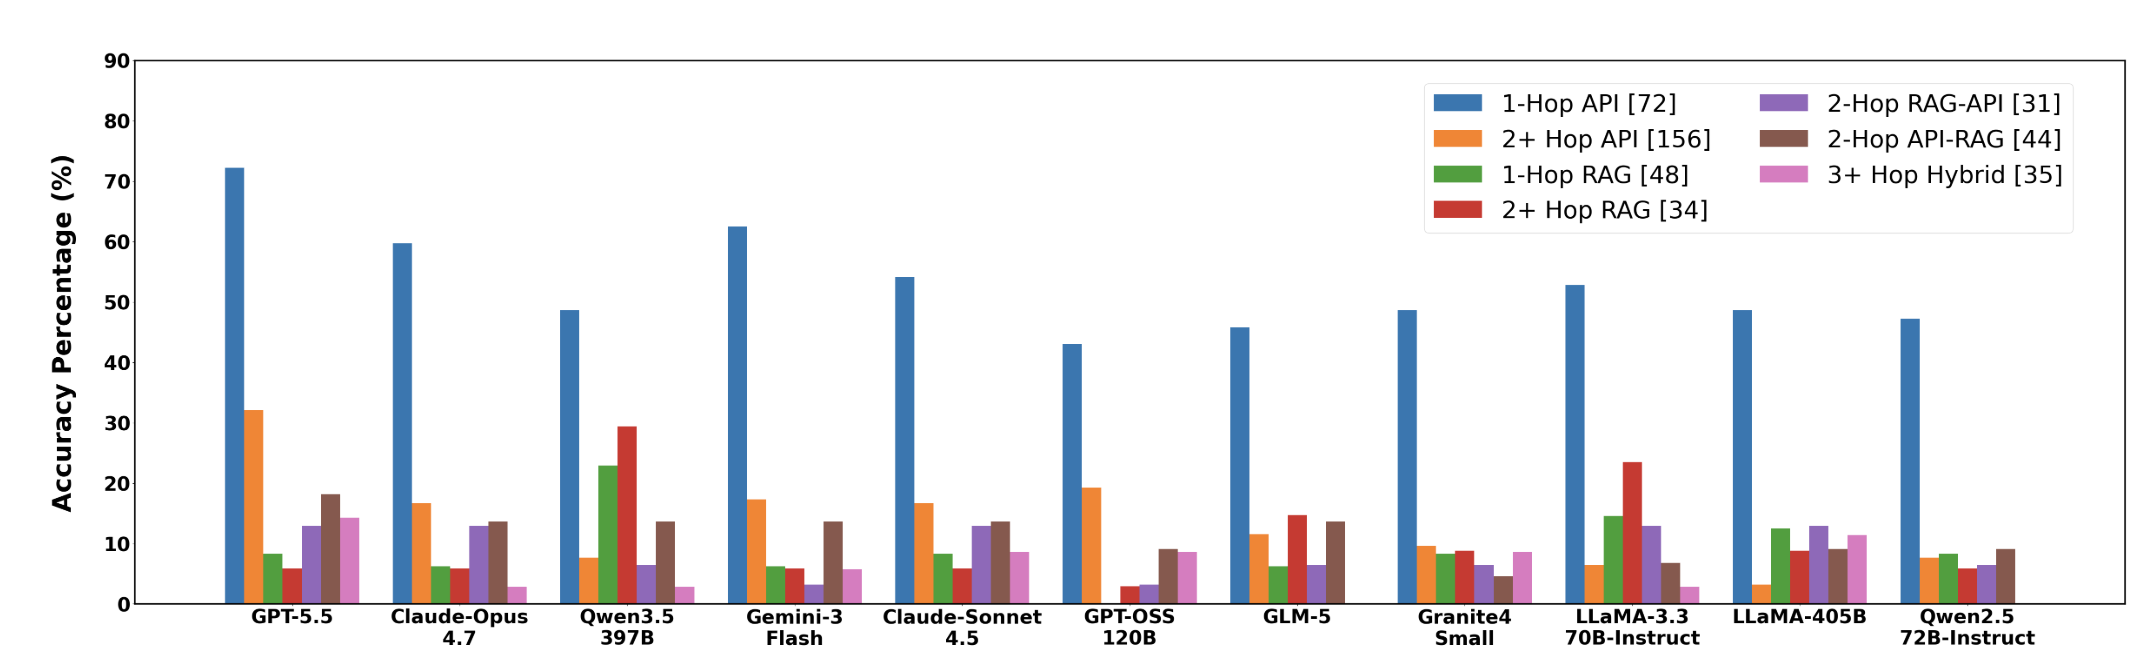
Los resultados muestran una caída fuerte al aumentar la composición. El mejor modelo alcanza un 70,4 % en endpoints de un solo salto, pero se mueve alrededor del 50–51 % en APIs composicionales; el rendimiento cae más de un 50 % cuando aumenta la profundidad de razonamiento y llega a tan solo un 2,4 % en ciertas consultas no respondibles con políticas. Según el análisis de fallos, el cuello de botella está más en desambiguar entidades y conectar fuentes que en invocar técnicamente la herramienta.
La aportación para producto es una regla de evaluación: no basta con comprobar si el agente sabe llamar a cada endpoint. Hay que probar el enlace entre fuentes, la trazabilidad de la evidencia y la obediencia a políticas. Aun así, VAKRA es un benchmark ejecutable y no reproduce por completo permisos, latencias, datos incompletos o las consecuencias de una acción real en un sistema enterprise.
- PROBLEMA
- Los benchmarks suelen separar tool-use y retrieval, aunque una operación real necesita cruzarlos y respetar permisos, políticas y entidades ambiguas.
- MÉTODO
- Evalúa tareas en las que el agente tiene que cruzar APIs, documentos y políticas. La dificultad no está en una llamada aislada, sino en mantener identidad, evidencia y restricciones a través de varios saltos.
- TIPO DE EVIDENCIA
- Benchmark con miles de APIs ejecutables y dominios heterogéneos; ofrece una medida más cercana a la composición enterprise que los tests de herramienta aislados.
- LÍMITE
- Un benchmark ejecutable no reproduce completamente permisos, latencias, datos incompletos ni consecuencias de una acción real.
 (sitio externo; abre en una pestaña nueva)
Accuracy por tipo de interacción: el gráfico muestra cómo se separan las tareas de API, RAG y sus combinaciones multi-hop.
Ankita Rajaram Naik et al. · VAKRA · arXiv:2608.12282v1 · CC BY-SA 4.0
Consultar licencia ↗ (sitio externo; abre en una pestaña nueva)Diseñar evaluaciones internas con entidades ambiguas, políticas explícitas y una trazabilidad mínima de por qué se usó cada fuente.
La lectura también deja rastro.
Guarda una observación junto a la evidencia. Tú escribes aquí; los agentes pueden añadir notas por MCP y aparecerán identificados.
LECTURA AMPLIADAMetodología, implicaciones y preguntas para volver al paper.+
Evalúa tareas en las que el agente tiene que cruzar APIs, documentos y políticas. La dificultad no está en una llamada aislada, sino en mantener identidad, evidencia y restricciones a través de varios saltos.
Ofrece una medida más realista del agente enterprise: no basta con saber llamar un endpoint; hay que saber cuándo, con qué evidencia y bajo qué política hacerlo.
Un benchmark ejecutable no reproduce completamente permisos, latencias, datos incompletos ni consecuencias de una acción real.
Cómo lo llevaría a un proyecto
Diseñar evaluaciones internas con entidades ambiguas, políticas explícitas y una trazabilidad mínima de por qué se usó cada fuente.
Preguntas que conviene probar
- ¿En qué salto de la cadena se concentra la pérdida de rendimiento?
- ¿Qué evidencia debe conservarse para poder auditar una decisión?
Si tuviera que convertirlo en una prueba mañana.
Mi lectura
La dificultad enterprise aparece en los enlaces entre fuentes, no en cada herramienta aislada.
Esta última frase es una inferencia editorial a partir del paper y de sus posibles implicaciones; no es una afirmación de los autores.
La prueba que queda en pie.
¿Un registro explícito de entidades, fuentes y políticas reduce el deterioro entre uno y tres saltos de herramienta?